Triton으로 FlashAttention 구현하기 전에 - FA1, 2 forward pass
FlashAttention은 현재 4까지 나와 있지만, 3과 4는 알고리즘 자체보다 Hopper, Blackwell 같은 최신 GPU의 기능을 활용한 최적화에 가깝다. Triton에서는 이런 하드웨어 수준의 최적화가 상당 부분 컴파일러의 몫이라, 이 글에서는 핵심 알고리즘이 담긴 FlashAttention 1과 2만 살펴본다. 범위는 forward pass로 한정한다.
왜 필요한가
일반적인 attention은 , , 를 단계별로 계산하면서, 크기의 와 를 매번 GPU 메모리(HBM)에 썼다가 다시 읽는다. 문제는 HBM이 크지만 상대적으로 느리다는 점이다. 연산은 SM 안의 작고 빠른 SRAM에서 하는데, 그 사이를 큰 행렬이 계속 오가니 attention은 계산량보다 메모리 IO가 병목이 된다.
그렇다면 커널 퓨전으로 부터 까지 한 번에 처리해서, 와 를 HBM에 쓰지 않으면 되지 않을까? 여기서 softmax가 걸린다.
분모를 구하려면 한 행의 원소를 전부 봐야 하는데, 이 길어지면 행 하나도 SRAM에 다 들어가지 않는다. 그래서 행 전체를 보지 않고도 softmax를 계산하는 방법이 필요하고, 그것이 online softmax다.
GPU 메모리 계층이나 memory-bound에 대한 자세한 설명은 FlashAttention 논문과 ELI5: FlashAttention에 잘 정리되어 있다.
Online Softmax 개념
safe softmax는 최댓값 을 먼저 구하고, 그 으로 지수의 합 을 구한 뒤, 마지막으로 나눈다. 앞 단계가 끝나야 다음 단계를 시작할 수 있으니 입력을 세 번 훑어야 한다.
online softmax(Milakov & Gimelshein, 2018)는 처음 두 단계를 한 번에 처리한다. 최댓값을 미리 모르는 대신, 지금까지의 최댓값 과 그 기준의 합 을 들고 가다가 최댓값이 바뀌면 지금까지의 합을 새 기준으로 보정한다.
최댓값이 그대로면 보정 배율 은 1이고, 바뀌면 1보다 작아져서 이전 합을 줄인다. 원소 대신 블록 단위로 봐도 똑같이 성립한다. 블록 안에서는 최댓값과 합을 한꺼번에 구하고, 블록끼리는 같은 식으로 합치면 된다.
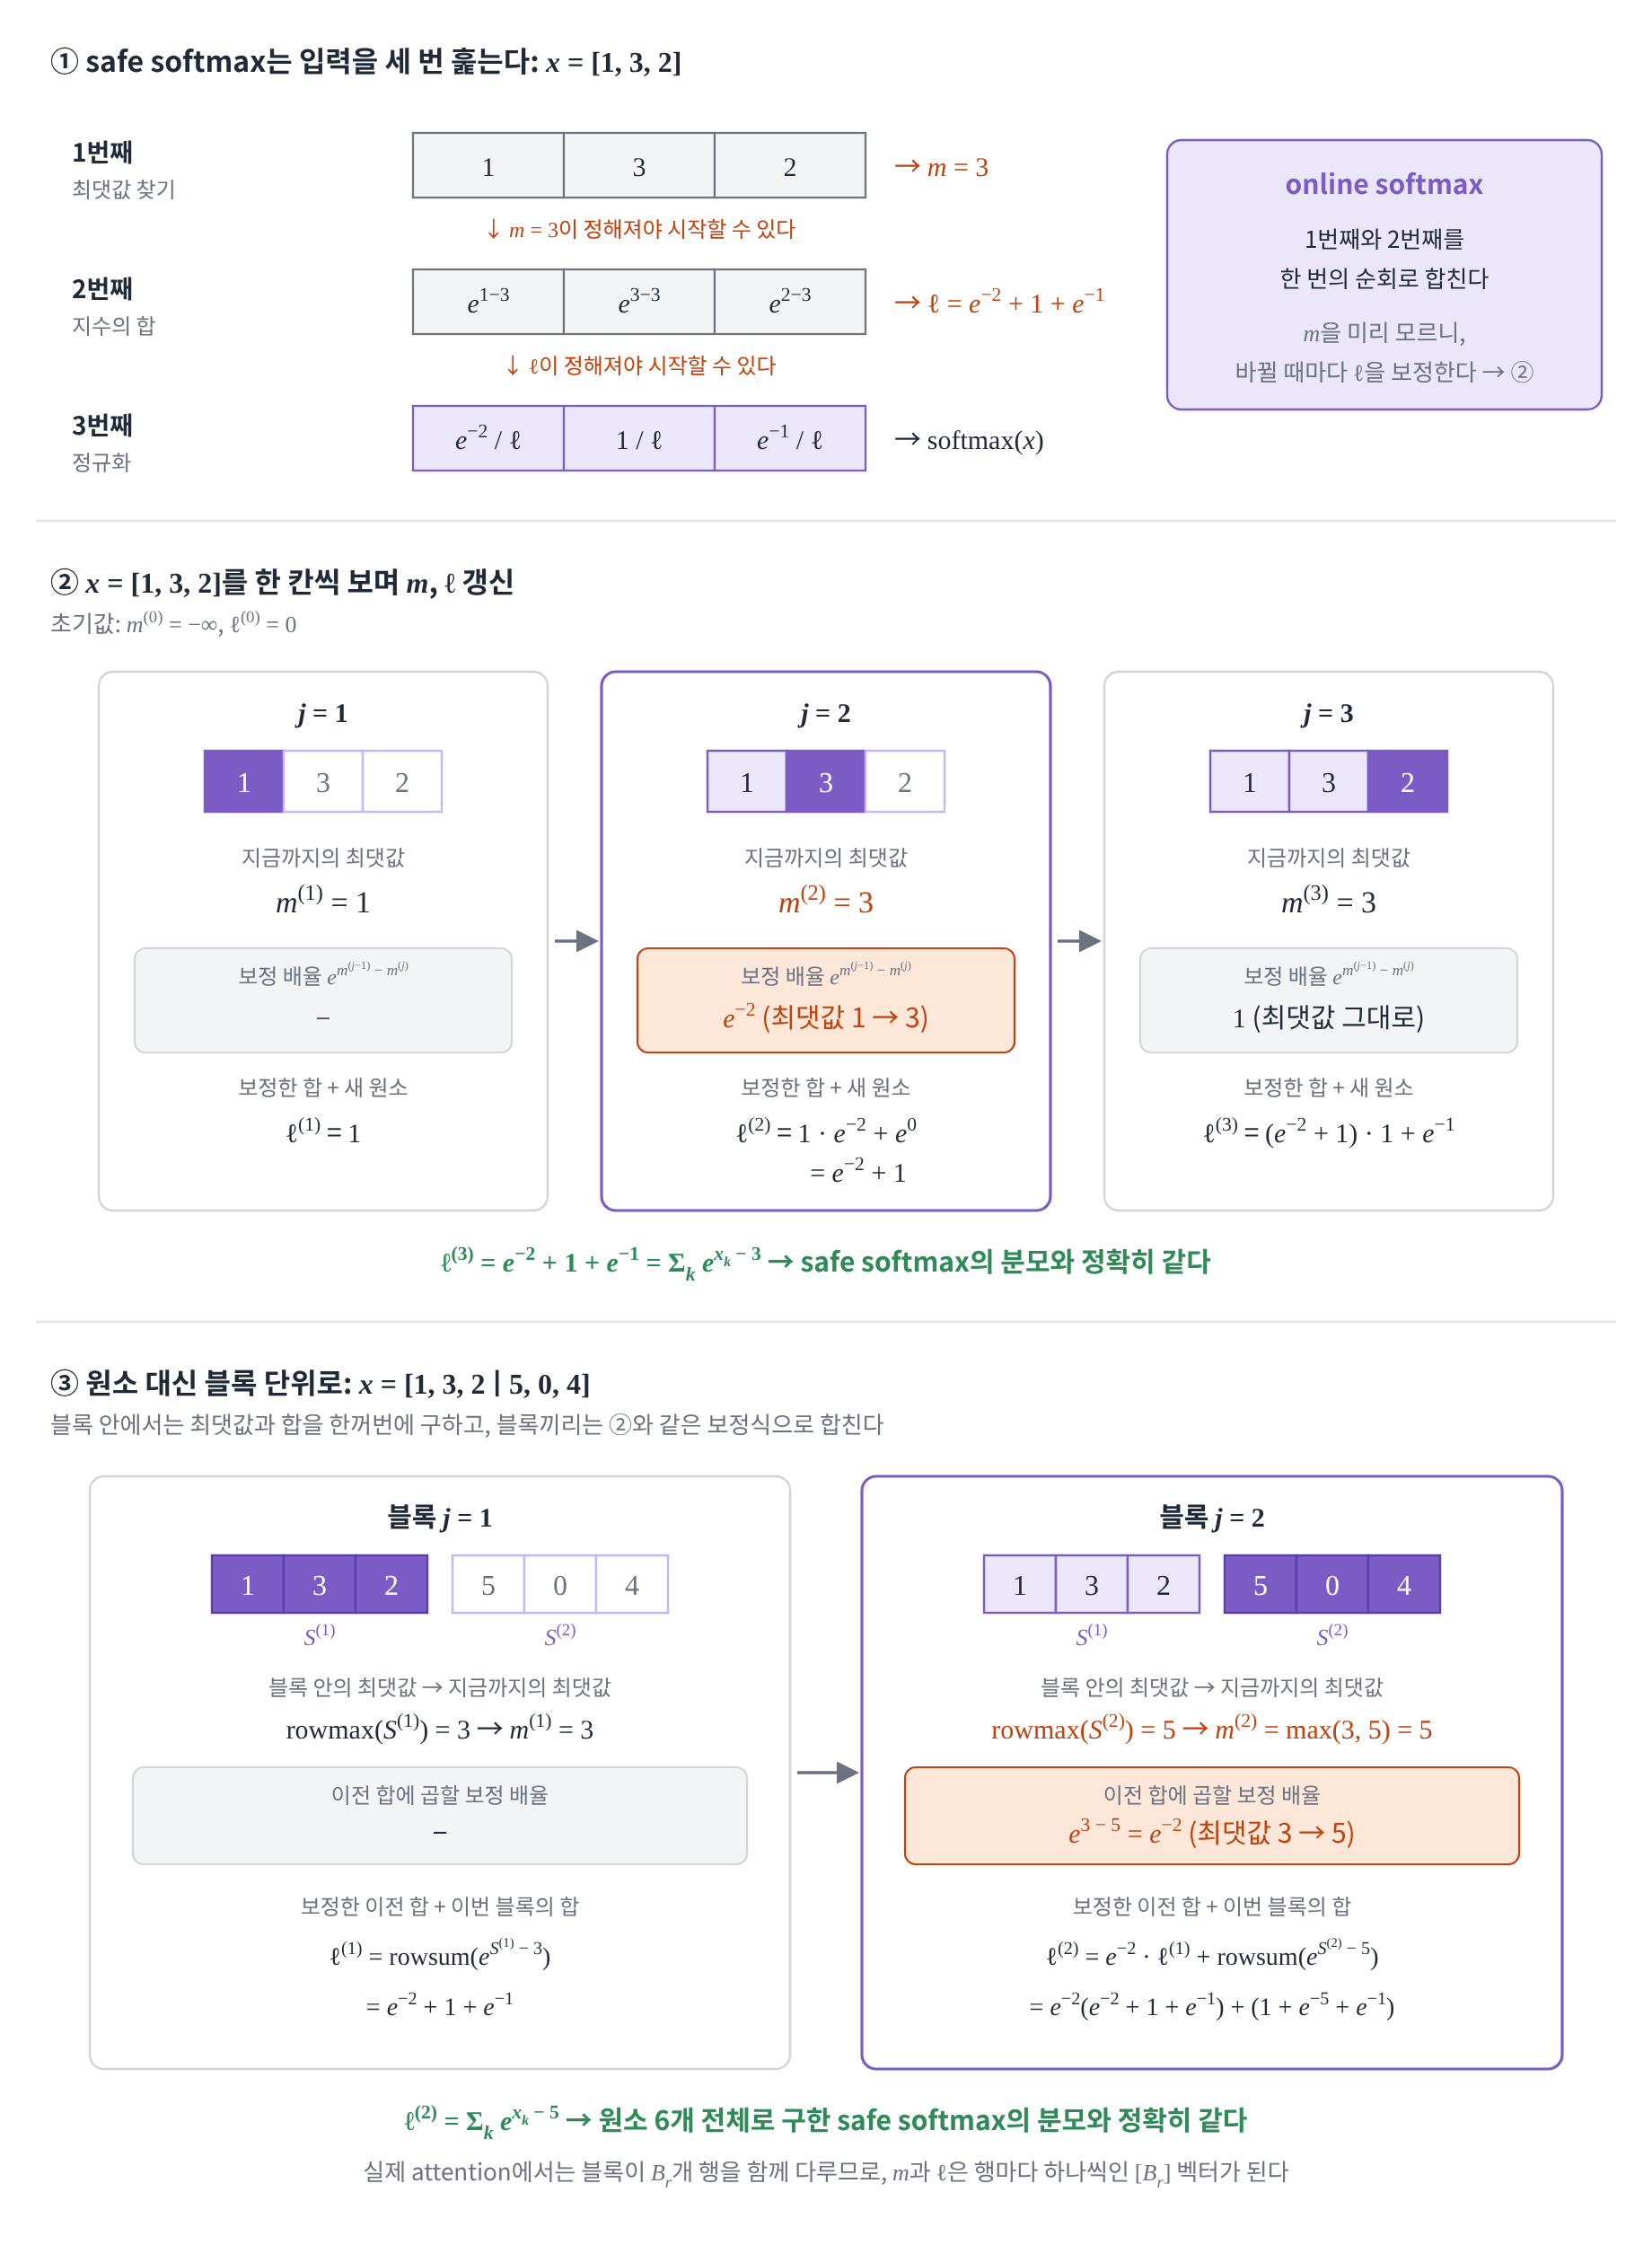
그림의 ①은 safe softmax가 왜 세 번 훑어야 하는지, ②는 를 한 칸씩 보며 과 이 갱신되는 과정, ③은 같은 일을 블록 단위로 하는 모습이다. 어느 쪽이든 최종 은 safe softmax의 분모와 정확히 같다.
다만 softmax 결과 자체가 필요하면, 최종 과 로 나누기 위해 여전히 한 번 더 훑어야 한다. 그런데 attention에 필요한 것은 가 아니라 다. 그렇다면 을 보정한 것처럼 출력 도 같이 보정하며 누적하면, 를 저장하지 않고 한 번의 순회로 끝낼 수 있지 않을까? 이것이 FlashAttention의 출발점이다.
FlashAttention 1 forward pass 알고리즘 분석
연산에 필요한 추가적인 인자부터 보자. SRAM 크기를 이라고 하면, FA1은 블록 크기 , 와 블록 개수 , 를 이렇게 정한다.
로 나누는 이유는 , , , 네 블록을 SRAM에 함께 올려야 하기 때문이다. 로 제한하면 score 블록 ()도 안에 들어간다. 다만 이 공식은 분석을 위한 이론적인 값이고, 실제 구현은 64나 128 같은 고정된 블록 크기를 쓴다.
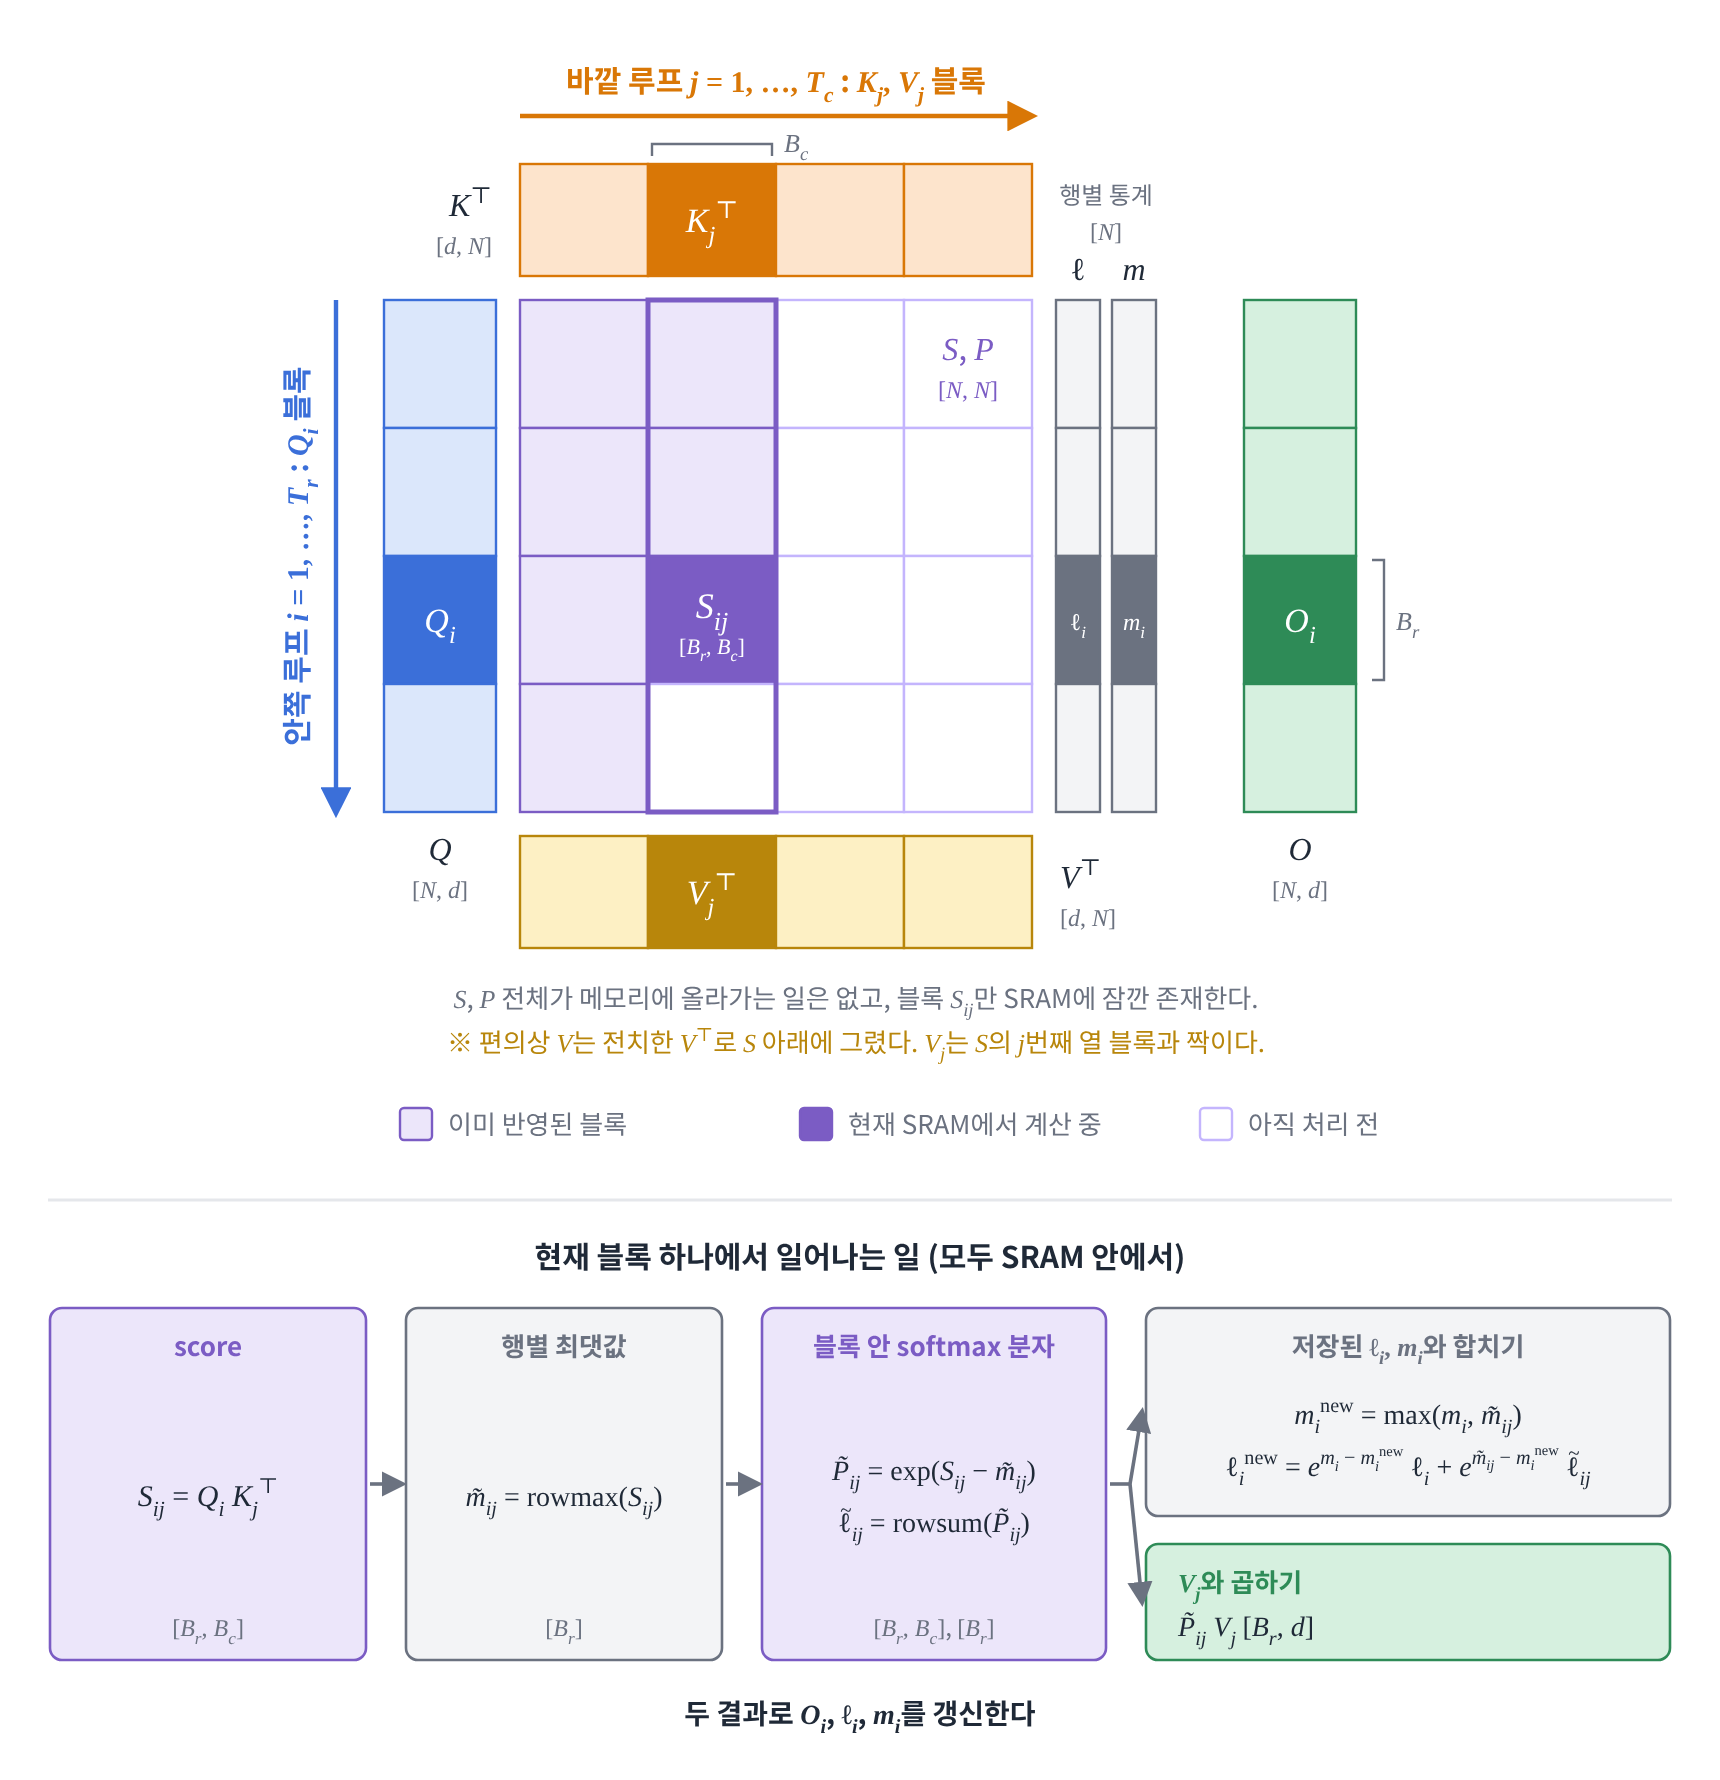
FA1의 루프는 **바깥이 , 안쪽이 **다. , 를 SRAM에 올려 두고 모든 를 돌면서, 블록 하나마다 그림 아래의 과정을 거친다.
- 를 계산한다.
- 블록 안에서 최댓값 , 분자 , 합 를 구한다. online softmax에서 블록 하나를 처리하는 것과 같다.
- HBM에서 불러온 이전 통계값 , 와 합치고, 로 출력 를 갱신한다.
와 전체는 어디에도 저장되지 않는다. HBM에 추가로 남는 것은 행마다 하나씩인 , 뿐이라 메모리가 이다. 이 두 값은 backward에서 , 를 블록 단위로 다시 계산할 때도 쓰인다.
이제 3번의 갱신을 자세히 보자.
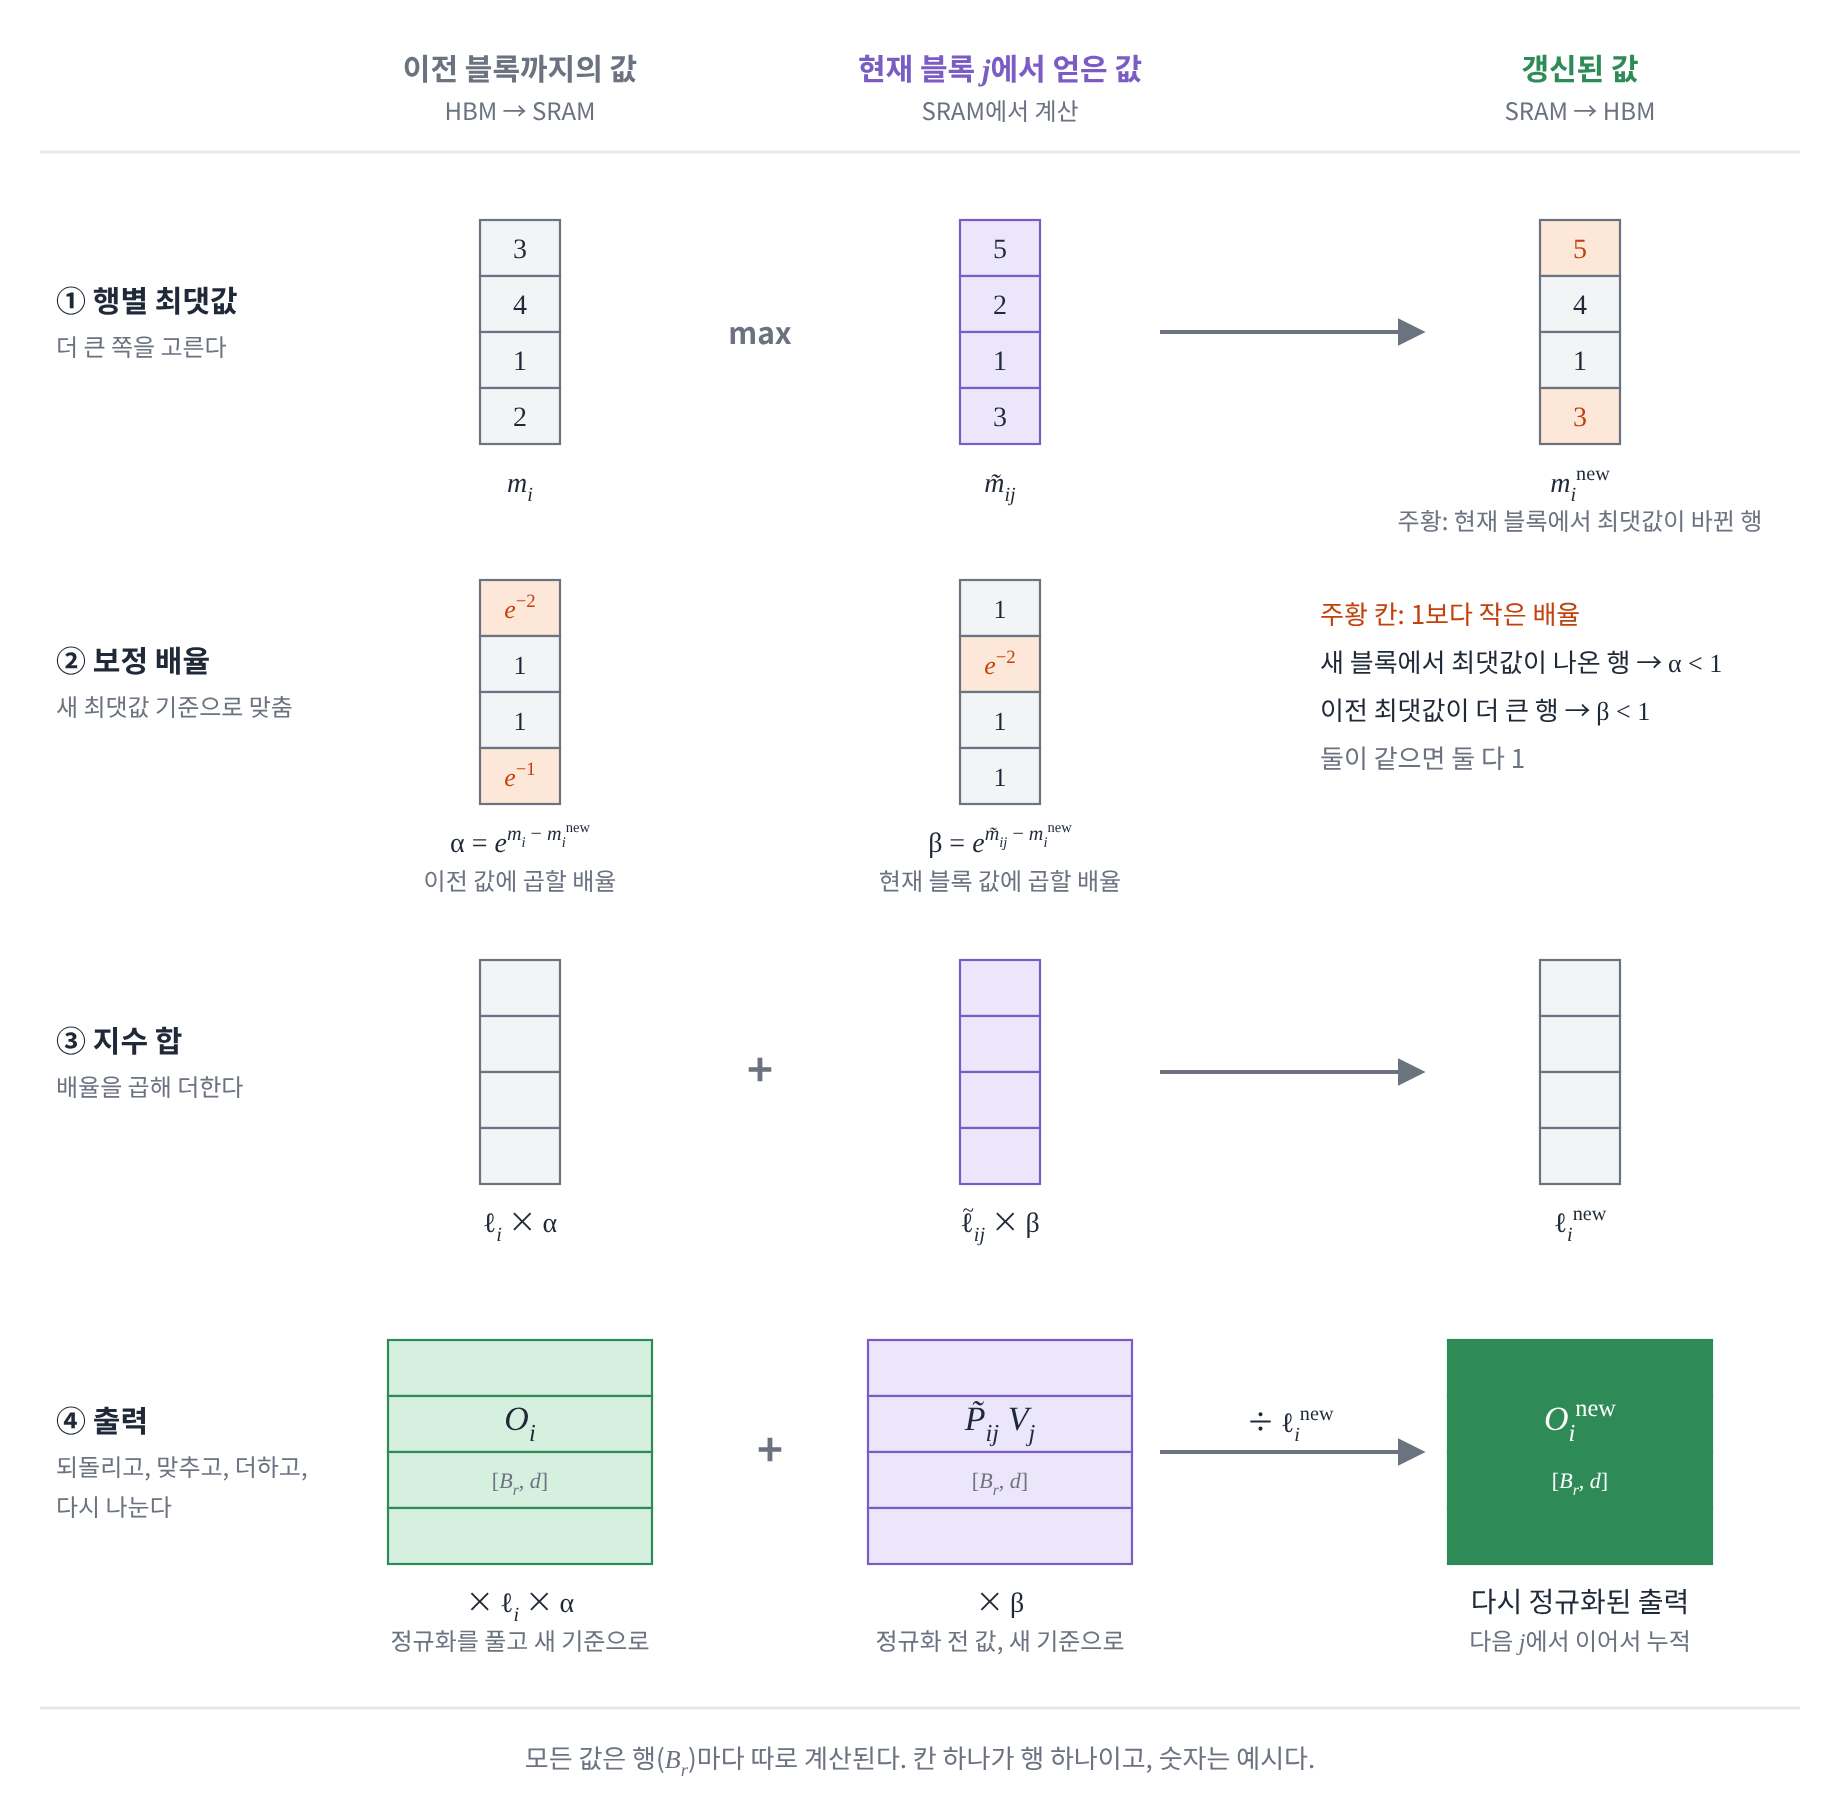
이전 값과 현재 블록 값은 서로 다른 최댓값 기준으로 계산되어 있다. 그래서 둘 다 새 최댓값 기준으로 맞춰야 하는데, 이전 값에 곱하는 배율을 , 현재 블록 값에 곱하는 배율을 라고 하면 식은 이렇게 정리된다.
FA1은 를 항상 정규화된 상태로 저장한다. 그래서 불러온 에 를 곱해 정규화를 풀고, 보정해서 더한 뒤, 새 분모 로 다시 나눈다.
마지막으로 루프 구조를 다시 보면, 갱신된 , , 는 매번 HBM에 썼다가 다음 에서 다시 읽는다. 바깥 루프가 번 도니 같은 가 HBM을 번 왕복하는 셈이다.
무엇을 개선할 수 있나?
FA1으로 attention의 메모리 문제는 풀렸지만, FA2 논문에 따르면 FA1은 forward pass만 놓고 봐도 A100 이론 성능의 30~50% 정도밖에 쓰지 못했다. 원인은 크게 네 가지다.
1. 가 HBM을 계속 왕복한다. 바깥 루프가 라서, 같은 행 블록의 , , 를 바깥 루프가 돌 때마다 HBM에서 읽고 다시 쓴다. 행 블록 하나당 번 왕복하는 셈이다.
2. 행렬곱이 아닌 연산이 많다. 를 정규화된 상태로 유지하려고 매 블록마다 를 곱했다가 다시 나누고, 배율도 , 두 개를 곱한다. GPU는 행렬곱을 Tensor Core로 매우 빠르게 처리하지만 나머지 연산은 훨씬 느리다. A100 기준으로 FP16 행렬곱은 312 TFLOPS인데, 행렬곱이 아닌 FP32 연산은 19.5 TFLOPS로 16배 가까이 차이 난다. 그래서 이런 연산은 조금만 늘어도 전체 시간에 크게 영향을 준다.
3. 병렬화가 batch × head 단위로만 이루어진다. thread block 하나가 head 하나를 통째로 맡는다. sequence가 길어서 batch를 작게 잡으면 thread block 수가 SM 개수보다 적어져 GPU가 논다.
4. thread block 안에서도 warp끼리 결과를 합쳐야 한다. FA1은 , 를 warp들에 나눠 맡기기 때문에(split-K), 마지막에 warp들의 부분 결과를 shared memory를 거쳐 합쳐야 한다. 이건 Triton에서는 컴파일러가 결정하는 영역이라 이 글에서는 이런 차이가 있다는 정도만 짚고 넘어간다.
FA2는 이 문제들을 어떻게 풀었을까?
FlashAttention 2 forward pass 알고리즘 분석
FA2의 가장 큰 변화는 루프 순서다.
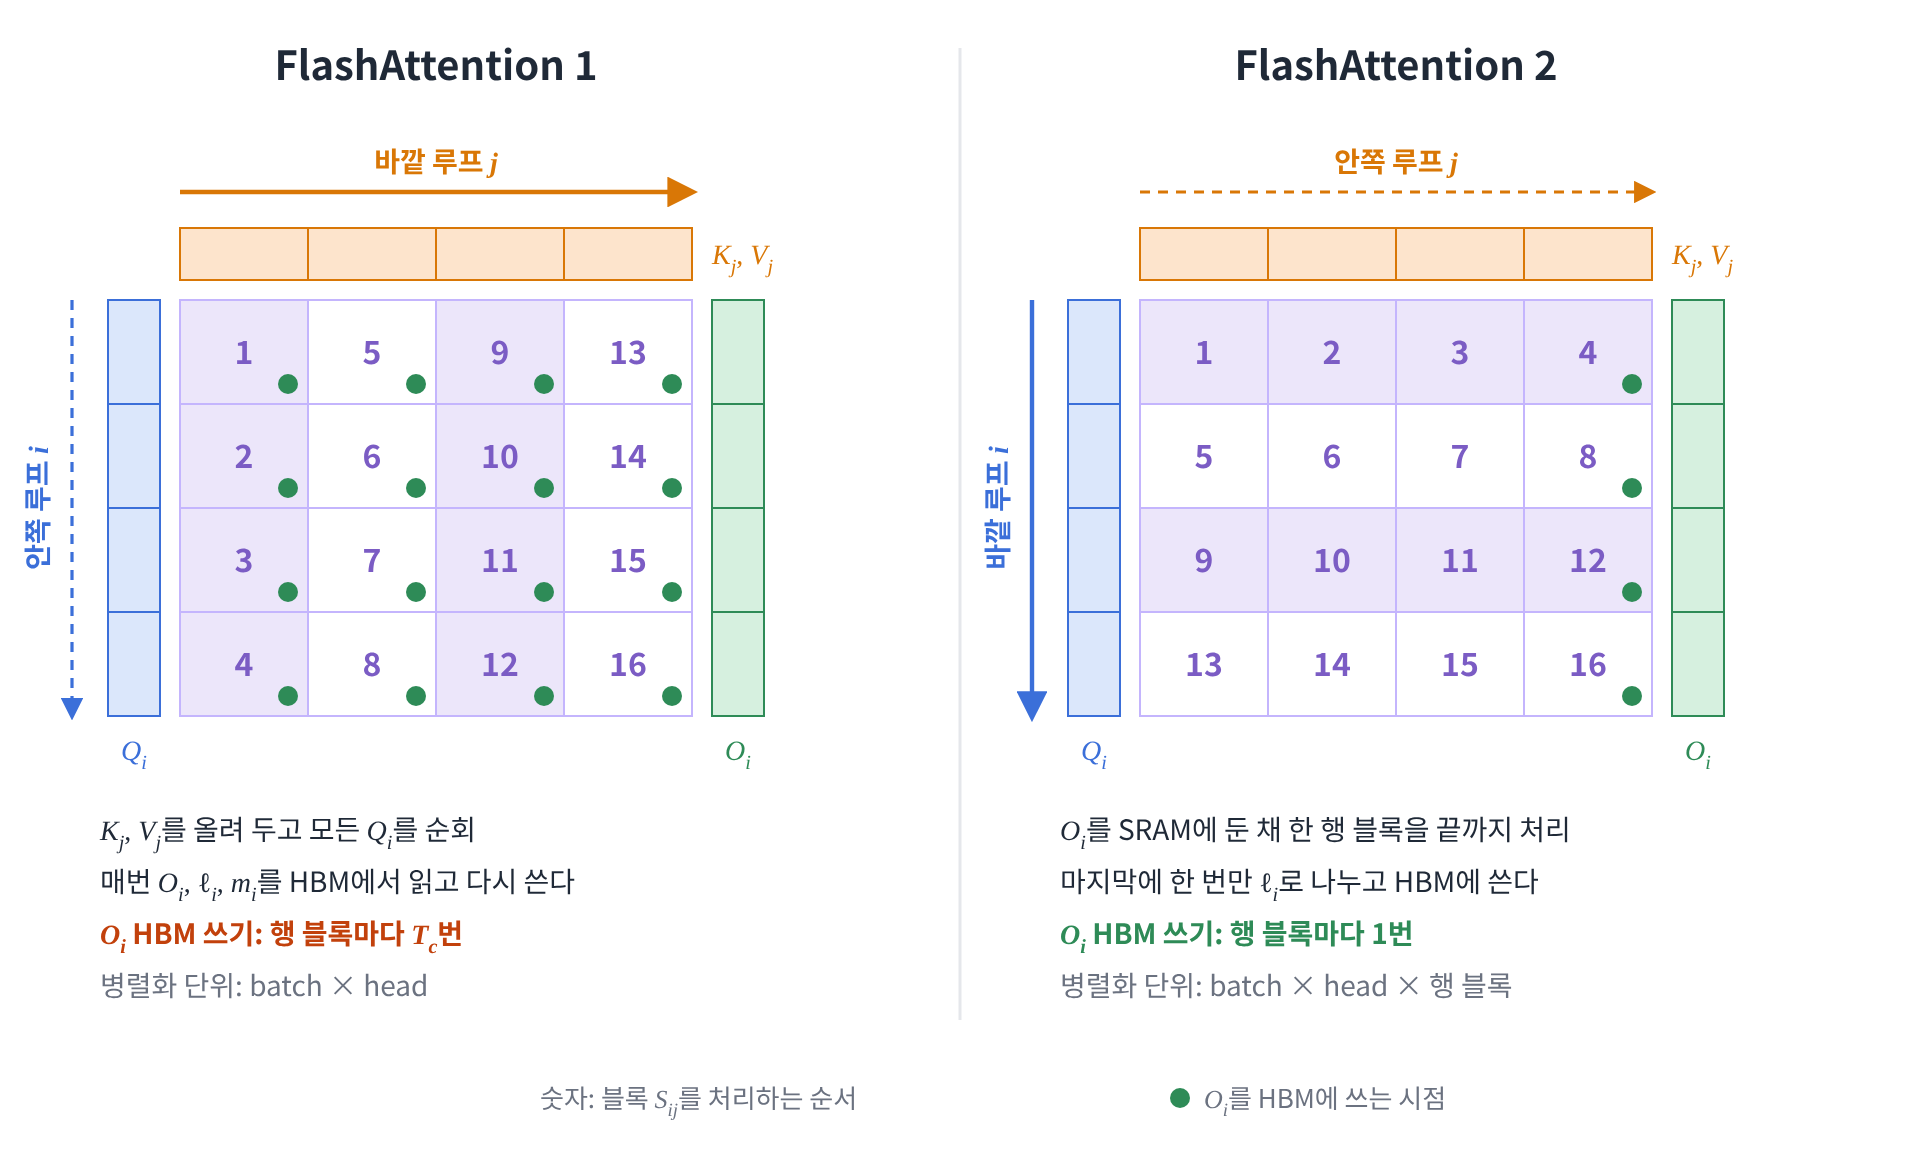
바깥 루프를 로, 안쪽 루프를 로 바꾸면 한 행 블록을 처음부터 끝까지 이어서 처리하게 된다. 그동안 , , 는 SRAM에 머물 수 있고, HBM에는 행 블록이 끝났을 때 한 번만 쓰면 된다. 게다가 행 블록끼리는 서로 의존하지 않으니, 행 블록마다 thread block을 따로 띄워 sequence 방향으로도 병렬화할 수 있다. 앞에서 짚은 1번과 3번 문제가 이것 하나로 함께 풀린다.
블록 크기는 FA1처럼 공식으로 정하지 않고, 중에서 head dimension과 shared memory 크기에 맞춰 고른다.
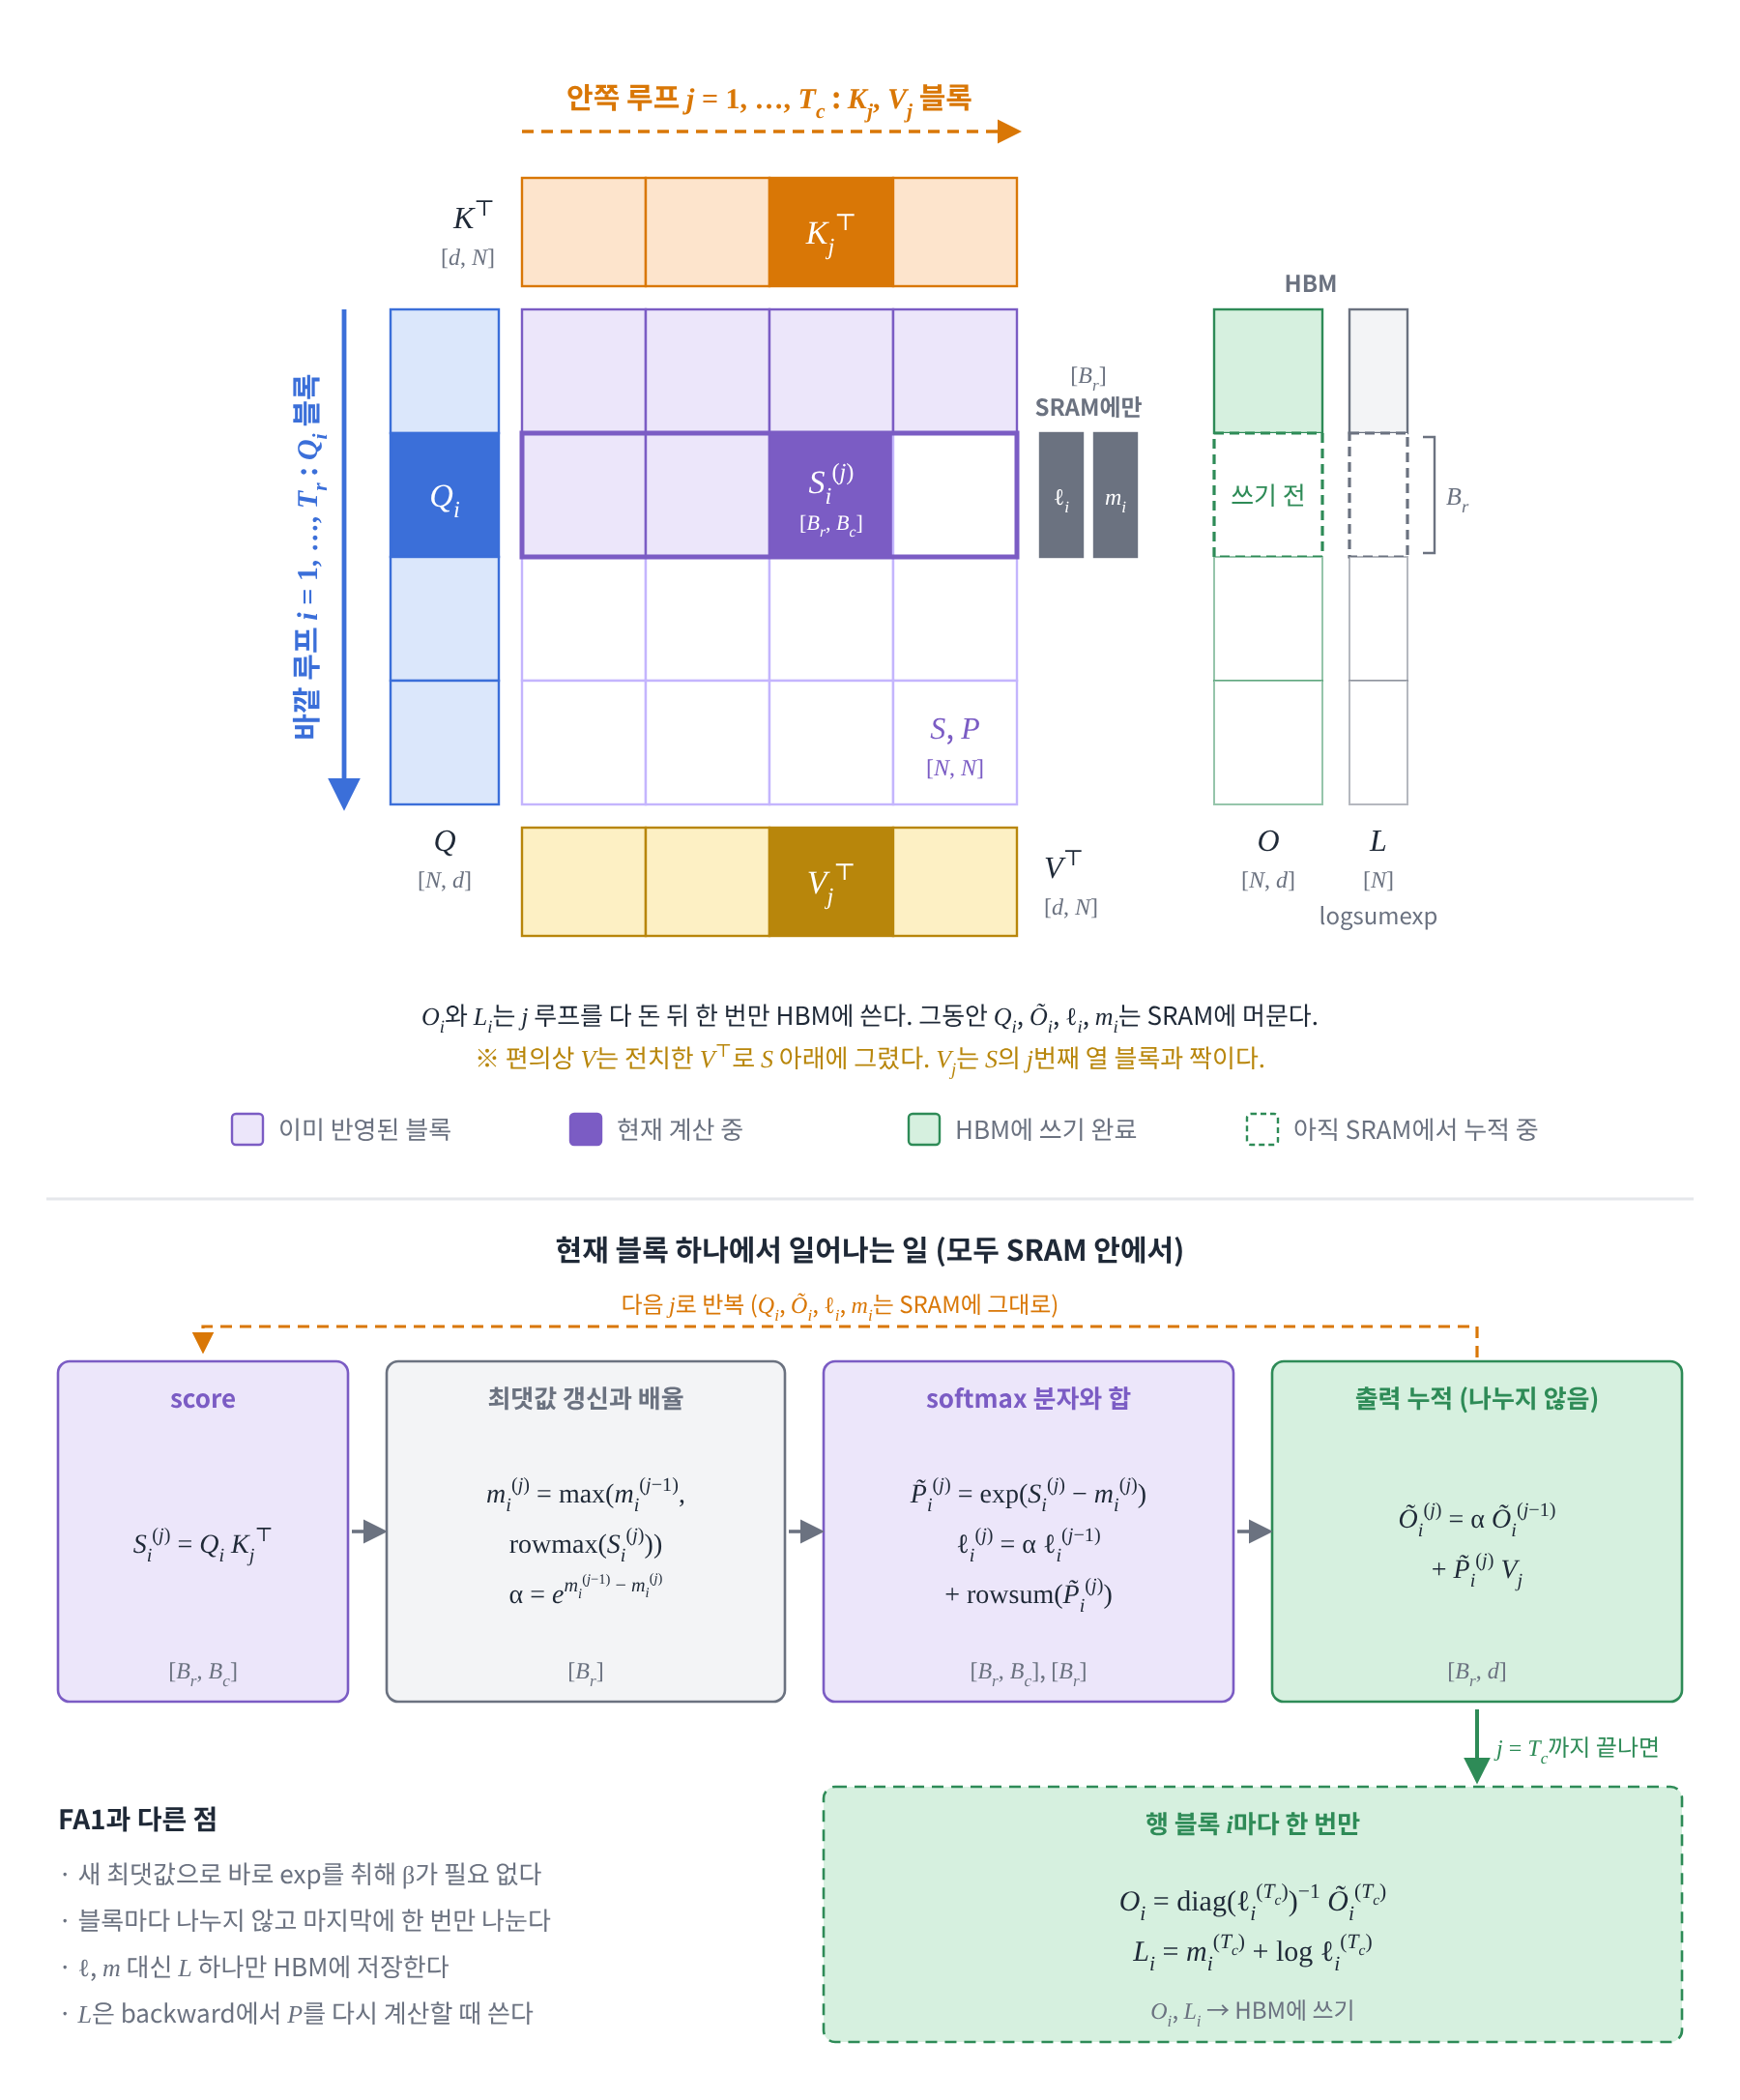
FA1 그림과 비교하면, 격자가 열이 아니라 행 단위로 채워진다. , 는 현재 행 블록 것만 SRAM에 있고, HBM에는 와 (logsumexp)만 있다. 여기서부터는 FA2 논문을 따라, 번째 블록까지 처리한 값을 위첨자 로 쓴다. 블록 하나마다 하는 일은 이렇다.
- 를 계산한다.
- 최댓값을 바로 갱신한다. FA1처럼 블록 안 최댓값 를 따로 두지 않고, 지금까지의 최댓값과 바로 비교한다.
- 새 최댓값 기준으로 와 를 구한다.
- 출력 에 누적하되, 나누지 않는다.
루프가 끝나면 로 한 번 나누고, 와 를 HBM에 쓴다.
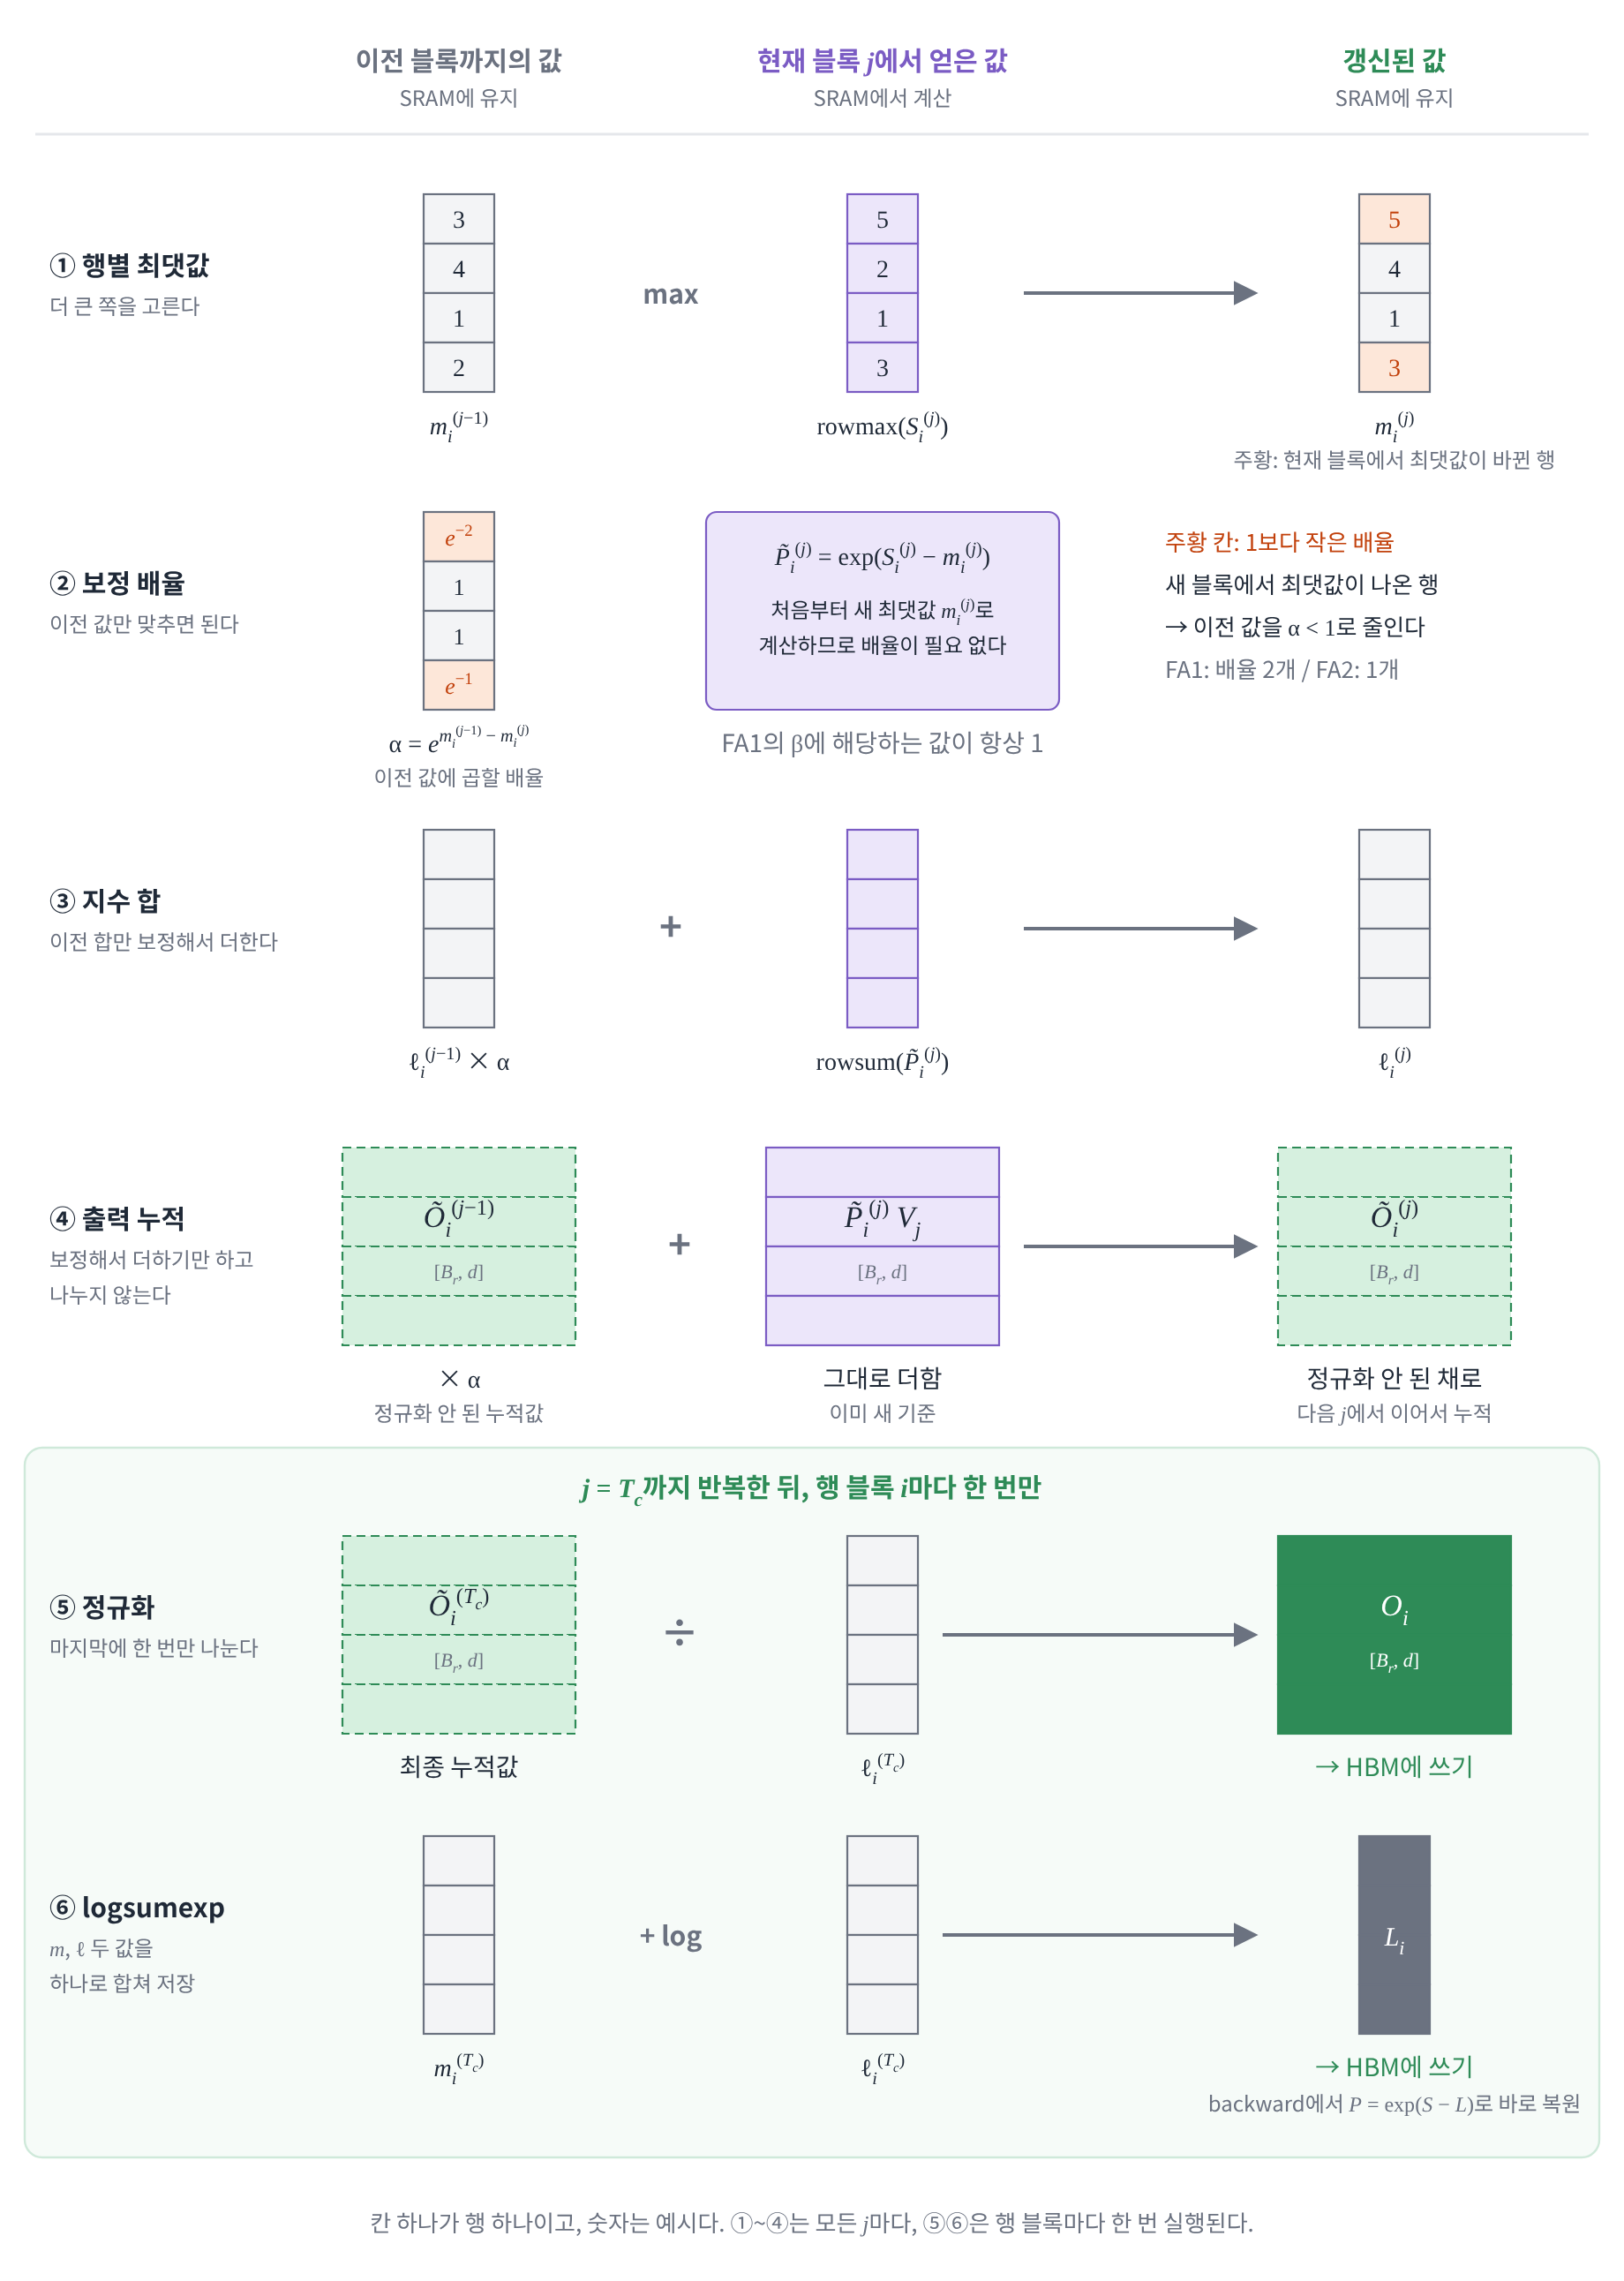
FA1과 같은 숫자 예시로 비교해 보면 차이가 분명하다. 를 처음부터 새 최댓값 로 계산하니, FA1의 에 해당하는 값은 항상 1이 된다. 이전 값에 곱하는 하나만 남는다.
FA1은 를 매 블록 정규화된 상태로 저장해야 해서 을 곱했다가 다시 나눴다. FA2는 가 SRAM에 계속 머무니 그럴 필요가 없다. 가 사라지고 나눗셈도 마지막 한 번으로 줄어들면서, 앞에서 짚은 2번 문제도 해결된다. 루프가 끝난 뒤에는 이렇게 마무리한다.
는 와 를 하나로 합친 값이다. backward에서는 저장하지 않은 를 로부터 다시 계산해야 하는데, 하나만 있으면 정규화된 를 바로 얻을 수 있다.
그래서 FA1처럼 과 을 따로 저장할 필요가 없다.
남은 4번(warp 간 작업 분할)은 FA2에서 대신 를 warp들에 나누는 방식(split-Q)으로 바뀌어, warp끼리 결과를 합칠 필요가 없어졌다. 다만 앞서 말했듯 Triton에서는 컴파일러가 정하는 영역이라 이 글에서는 넘어간다.
정리
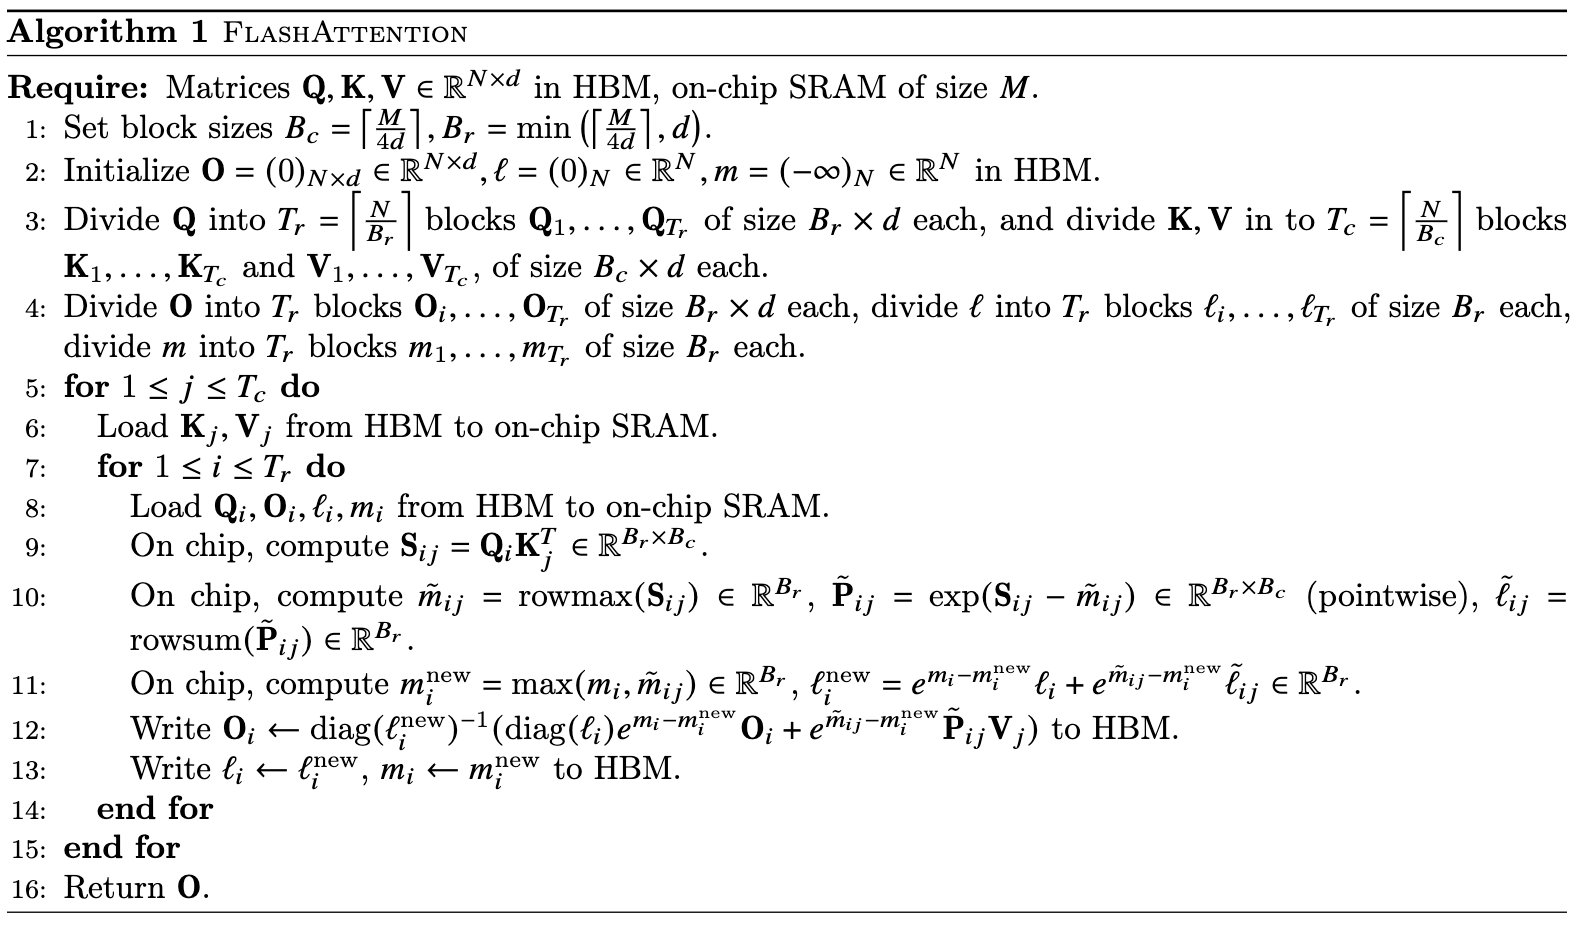
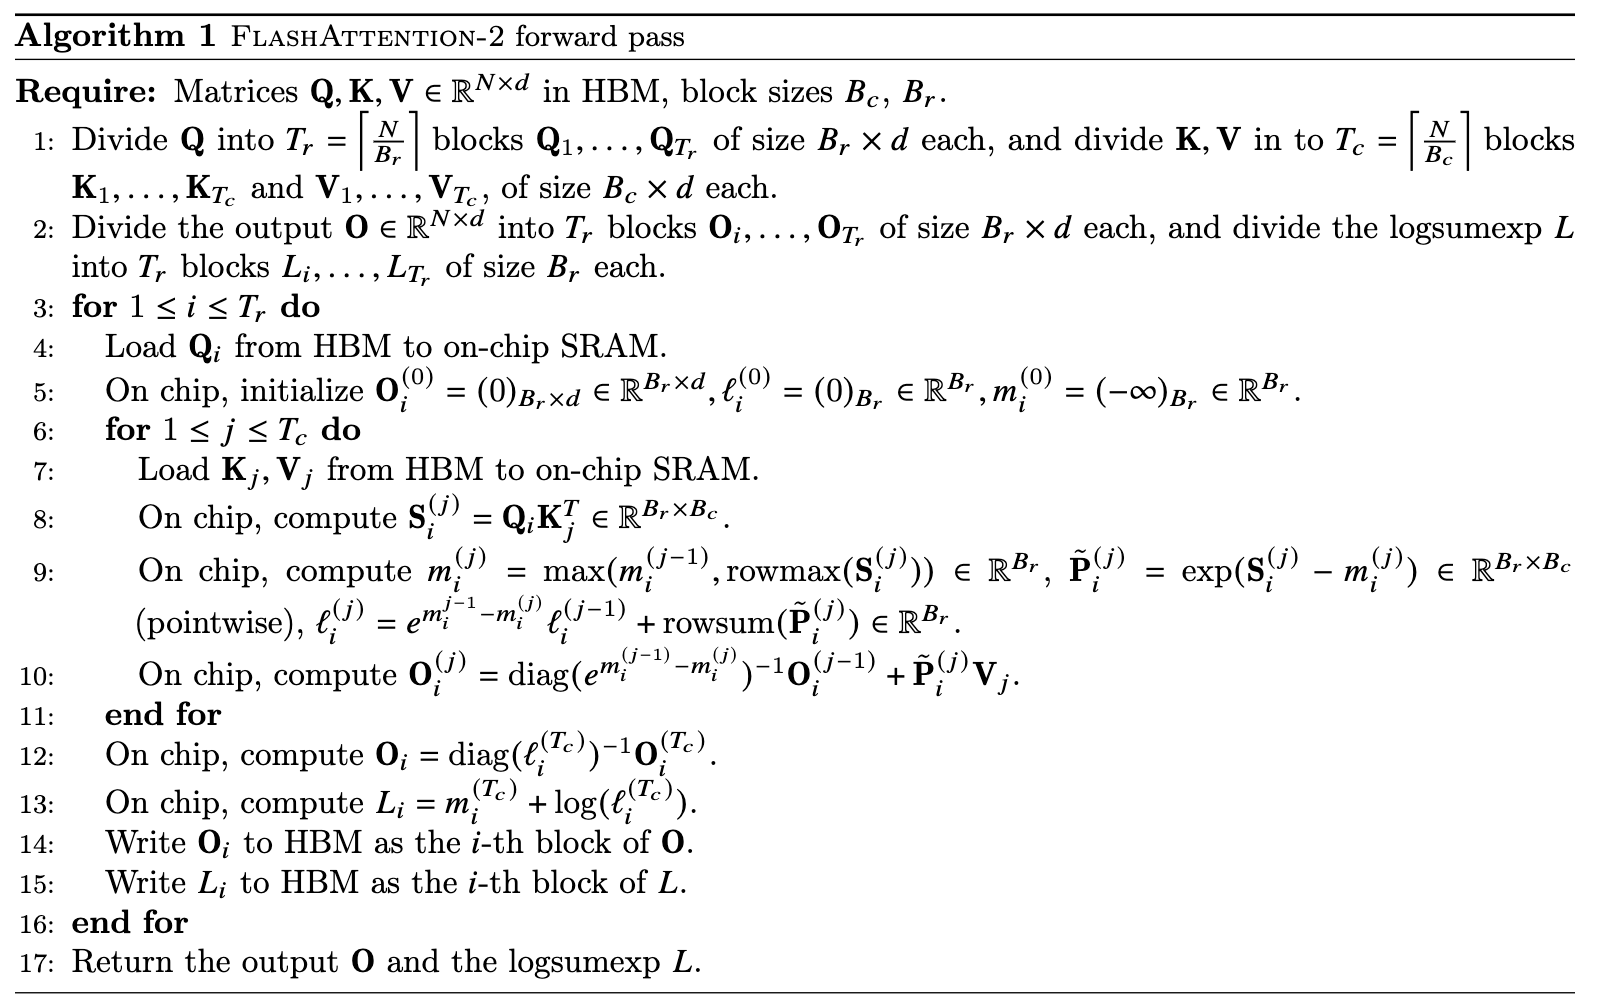
두 알고리즘은 같은 수학(tiling + online softmax)을 쓰지만, 그것을 GPU 위에 배치하는 방식이 다르다.
| FA1 | FA2 | |
|---|---|---|
| 바깥 / 안쪽 루프 | / | / |
| 블록 크기 | , | 에서 튜닝 |
| HBM 읽기 | 번 | 1번 |
| HBM 읽기 | 1번 | 번 |
| HBM 읽기 / 쓰기 | 번 / 번 | 0번 / 1번 |
| HBM에 남기는 통계값 | , (2개) | (1개) |
| 블록당 보정 배율 | , | |
| 블록당 원소별 연산 | 3번 (, , ) | 1번 (), 마지막에 1번 |
| 병렬화 단위 | batch × head | batch × head × 행 블록 |
| warp 분할 | split-K | split-Q |
| 추가 메모리 |
HBM 접근량을 head 하나 기준으로 대략 세 보면 다음과 같다(통계값처럼 크기가 인 항은 생략).
둘 다 블록 개수에 비례해 으로 늘어나는 건 같다. 하지만 FA1은 반복해서 오가는 텐서가 , 읽기, 쓰기 세 개이고, FA2는 , 두 개뿐이다. 특히 FA2는 HBM 쓰기가 행 블록마다 한 번으로 줄었다.
정리하면 FA1은 attention을 IO 관점에서 다시 설계해 행렬을 없앤 알고리즘이고, FA2는 같은 계산을 GPU가 더 잘 돌릴 수 있게 재배치한 것이다. 루프 순서를 바꾸고, 행렬곱이 아닌 연산을 줄이고, 병렬화 단위를 늘렸다. FA2 논문은 이렇게 해서 FA1보다 약 2배 빨라졌고, forward가 A100 이론 성능의 50~73%까지 올라갔다고 보고한다.
다음 글에서는 이 FA2 forward를 Triton으로 직접 구현해 본다.
참고
논문
- Tri Dao et al., FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, 2022
- Tri Dao, FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning, 2023
- Maxim Milakov, Natalia Gimelshein, Online normalizer calculation for softmax, 2018
- Markus N. Rabe, Charles Staats, Self-attention Does Not Need O(n²) Memory, 2021
- Jay Shah et al., FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision, 2024
구현
- Dao-AILab/flash-attention: 공식 구현
- Triton Tutorial: Fused Attention: Triton으로 구현한 FlashAttention v2
해설 글
- Aleksa Gordić, ELI5: FlashAttention
- Horace He, Making Deep Learning Go Brrrr From First Principles: compute-bound와 memory-bound 설명